AI Data Anonymization & Analytics System
The AI Data Anonymization & Analytics System is a comprehensive solution for secure data processing and intelligent analysis tailored to real enterprise business scenarios. Built on the core design principles of 'security-first, data-trustworthy, analysis-professional, and results-actionable,' it establishes an end-to-end workflow covering data import, quality checks, cleaning & structuring, sensitive information identification, rule-based anonymization, security review, intelligent analysis, and result restoration. The system employs a collaborative architecture combining rule engines with AI analytics, effectively separating sensitive data protection from professional data analysis. This approach reduces enterprise data leakage risks while unlocking the analytical value of operational, HR, and business process data. Through standardized processing flows, configurable security rules, and local statistical capabilities, it helps enterprises establish a trusted transformation mechanism from raw data to management insights—enabling AI to not only analyze data but also support business decisions within clearly defined security boundaries.
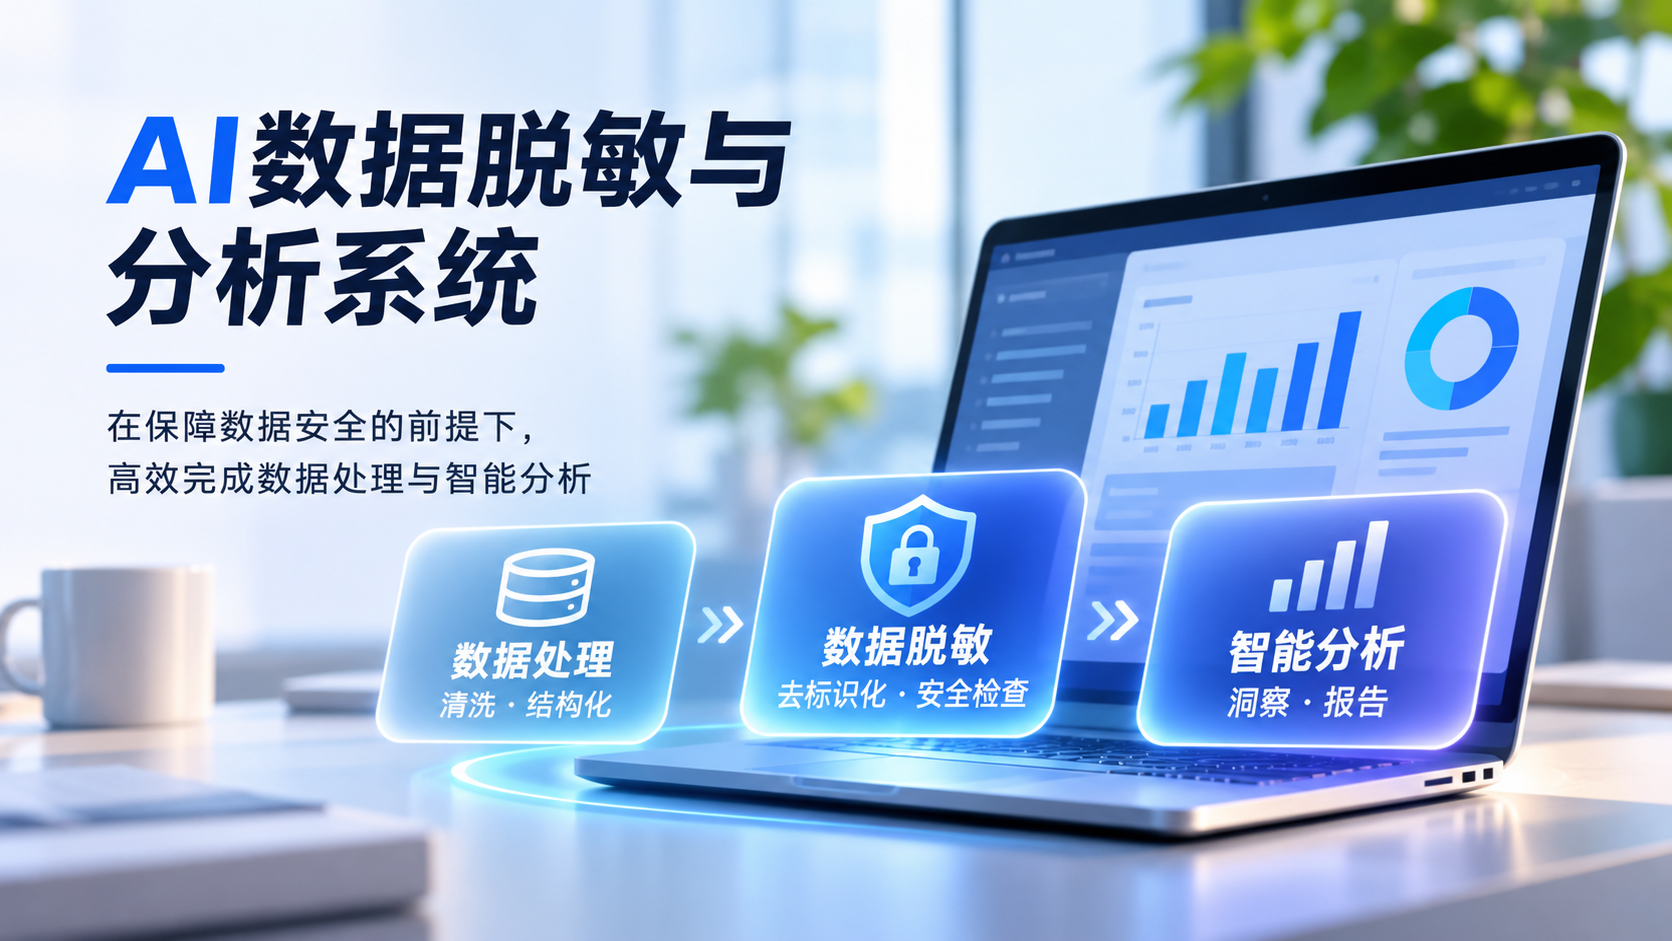
Core Capabilities
- Multi-source enterprise data integration & structuring: Supports common business data formats like Excel, providing data validation, field identification, quality inspection, cleaning, and structuring capabilities to establish standardized data foundations.
- Intelligent sensitive data identification & rule-based anonymization: Combines field type recognition, enterprise-sensitive term rules, and data processing strategies to identify, anonymize, and security-check personal information, business identifiers, and corporate sensitive data.
- Enterprise-grade data security review: Establishes security control mechanisms independent of AI models, performing rule validation and risk interception on processed data to prevent unchecked data from entering AI analysis workflows.
- Data anonymization & result restoration: Through task association, mapping management, and controlled restoration mechanisms, supports re-linking analysis results to actual business objects while protecting original sensitive information.
- Professional statistics & intelligent analysis: Offers descriptive statistics, correlation analysis, significance testing, and gradually extends to advanced methods like regression and cluster analysis—all aligned with enterprise management needs.
- Business-oriented result presentation: Transforms analysis outcomes into understandable business metrics, management conclusions, and analytical reports to help identify operational variances, uncover potential issues, and inform decision-making.
Highlights
- Security-analysis separation: Rules govern data security while AI handles business analysis, avoiding over-reliance on LLMs for sensitive data judgments and creating clearer system boundaries.
- Beyond basic anonymization: Integrates data cleaning, structuring, anonymization, security review, statistical analysis, and result restoration into a unified workflow, eliminating tool-switching and redundant processing.
- No direct AI exposure to sensitive data: Uses anonymized data packages and controlled analysis flows to preserve business-relevant data relationships while minimizing exposure risks.
- Hybrid statistical-AI approach: Local statistical engines handle deterministic tasks, complemented by AI's business interpretation capabilities, reducing unnecessary LLM dependencies.
- Actionable business reintegration: Supports authorized result restoration, allowing anonymized insights to reconnect with actual business entities—not just remain as abstract findings.
- Real-world management focus: Designed for operational, HR, and business process scenarios, prioritizing management problem-solving over technical metric displays.
Business Value
Reduces AI implementation risks: Establishes clearer security boundaries for enterprise AI analytics through standardized anonymization, security checks, and rule controls.
Enhances data processing efficiency: Systematizes repetitive data validation, cleaning, structuring, and statistical computations to reduce manual efforts and cross-tool operations.
Strengthens decision-making support: Helps managers identify trends, variances, and correlations in operational, HR, and process data to inform resource allocation and process improvements.
Unlocks data asset value: Transforms scattered Excel and system data into reusable analytical resources under secure, controlled conditions.
Democratizes advanced analytics: Standardized workflows and business-friendly presentations make insights accessible to non-technical managers.
Builds sustainable analytics capabilities: Shifts enterprises from ad-hoc manual processes to configurable, traceable data analysis mechanisms.
Case Details
AI Data Anonymization & Analytics System | AI Data Security & Analytics System
Security Governance · Professional Analytics · AI Collaboration
Establishes a complete technical chain from data cleaning, structure recognition, sensitive information anonymization, security checks to professional statistical analysis and result restoration—transforming enterprise data into trustworthy, actionable business insights within secure boundaries.
I. System Architecture Design
Adopts a modular, layered architecture with distinct components for data preprocessing, security governance, professional statistics, and AI collaboration.
Core principle: Deterministic tasks handled programmatically; non-deterministic tasks assisted by AI.
Local programs and rule engines manage data cleaning, field identification, anonymization, security checks, statistical computations, and result restoration. LLMs primarily handle business problem understanding, result interpretation, and management conclusion generation.
This design avoids entrusting data security judgments and numerical calculations entirely to LLMs, reducing risks of model hallucinations, computational biases, and sensitive data leaks while minimizing unnecessary token consumption.
II. Data Structure Recognition & Processing Engine
Incorporates Schema Detection to identify field types, business identifiers, entity relationships, and structural characteristics pre-processing.
For multi-sheet Excel data common in enterprises, the system establishes unified structural foundations through field type inference, identifier recognition, and cross-sheet consistency processing.
The processing layer employs rule-driven transformations supporting data type validation, missing value checks, format standardization, and structuring.
Engineering implementations include data versioning, rule snapshots, and diff mechanisms to distinguish raw, cleaned, and anonymized data—preventing version/configuration inconsistencies.
Key transformations require parameter consistency checks and version validations to prevent erroneous results from progressing downstream.
III. Sensitive Information Identification & Anonymization
Combines field types, business identifiers, and enterprise-sensitive term rules to classify personal information, corporate data, and business-sensitive fields.
The anonymization engine supports identifier substitution, data generalization, and mapping management.
For recurring business entities across sheets/records, the system maintains anonymization identifier consistency—preserving analytical relationships while protecting real identities.
Anonymization mappings are managed separately from AI analysis data, with task association mechanisms maintaining anonymous-to-real-object correspondences without exposing actual identifiers to AI.
Anonymization preserves statistical characteristics and analytical utility—not merely deleting sensitive fields.
IV. Independent Security Checks & Execution Controls
The security layer operates independently from AI models, combining rule validation with state constraints.
Pre-AI security checks validate sensitive field processing, identifier states, rule execution consistency, structural integrity, and potential credential leaks.
Non-compliant data triggers blocking—preventing unchecked data package generation.
Engineering safeguards include configuration validation, rule version snapshots, parameter consistency checks, and atomic data versioning to mitigate risks from misconfigurations or processing inconsistencies.
Security rule outcomes remain independent from LLM-generated explanations, preventing AI outputs from influencing security judgments.
V. Professional Statistical Analysis Engine
Local statistical engines handle deterministic computations separately from LLMs.
Base capabilities include COUNT, SUM, AVG, RATIO, DIFF operations.
Advanced functionalities cover correlation analysis, significance testing, linear/logistic regression, and cluster analysis with extensible architecture.
Key technical considerations:
1. Data-method compatibility
Validates whether field types, sample structures, and analysis goals meet statistical method prerequisites.
2. Repeated observations & independence
Identifies temporal data for the same employee/customer/supplier, applying conservative strategies when reliable identification isn't possible.
3. Statistical-business semantic linking
Preserves business labels alongside statistical outputs, ensuring correlations and differences clearly map to actual business fields—distinguishing statistical associations from unverified causal claims.
VI. AI Collaborative Analysis
Combines local computation with LLM strengths:
Statistical engines perform calculations; LLMs contextualize results and generate management reports.
AI-processed data undergoes security checks, using either anonymized datasets or structured statistical outputs.
This confines LLMs to semantic understanding and content generation—not sensitive data handling or deterministic computations.
Results clearly separate statistical facts from AI interpretations.
VII. Result Restoration & Task-Level Mapping
Controlled restoration mechanisms reconnect anonymized results to actual business objects via:
Task matching, mapping loading, version checks, and authorized replacements—all bound to specific data tasks.
Post-restoration validations ensure business-ready outputs.
This enables analysis-stage anonymity while restoring business interpretability under governance.
VIII. Engineering Design & Evolution
Task-driven workflows organize data import, structuring, cleaning, anonymization, security checks, analysis, and restoration with clear state boundaries.
Key design principles:
Modular decoupling: Separate components for data processing, security rules, statistics, and AI interpretation.
Configurable rules: Enterprise-sensitive terms and anonymization policies adjustable without code changes.
Version consistency: Rule snapshots, data versions, and diff controls manage state changes.
Security-first execution: Blocks downstream operations upon check failures—no forced overrides.
Local computation priority: Deterministic tasks avoid LLM dependencies for cost/accuracy benefits.
Analytical extensibility: Gradual incorporation of advanced statistical and ML methods.
The system's evolution aims to establish an enterprise intelligence architecture integrating data security governance, professional statistics, and AI business understanding.
Case Media
06:32