让AI记住经验,和让模型重新训练,是两回事
文章探讨了企业AI系统中经验积累与模型训练的区别,指出知识更新、记忆积累和参数训练是不同机制,需要针对性设计系统架构和维护流程。
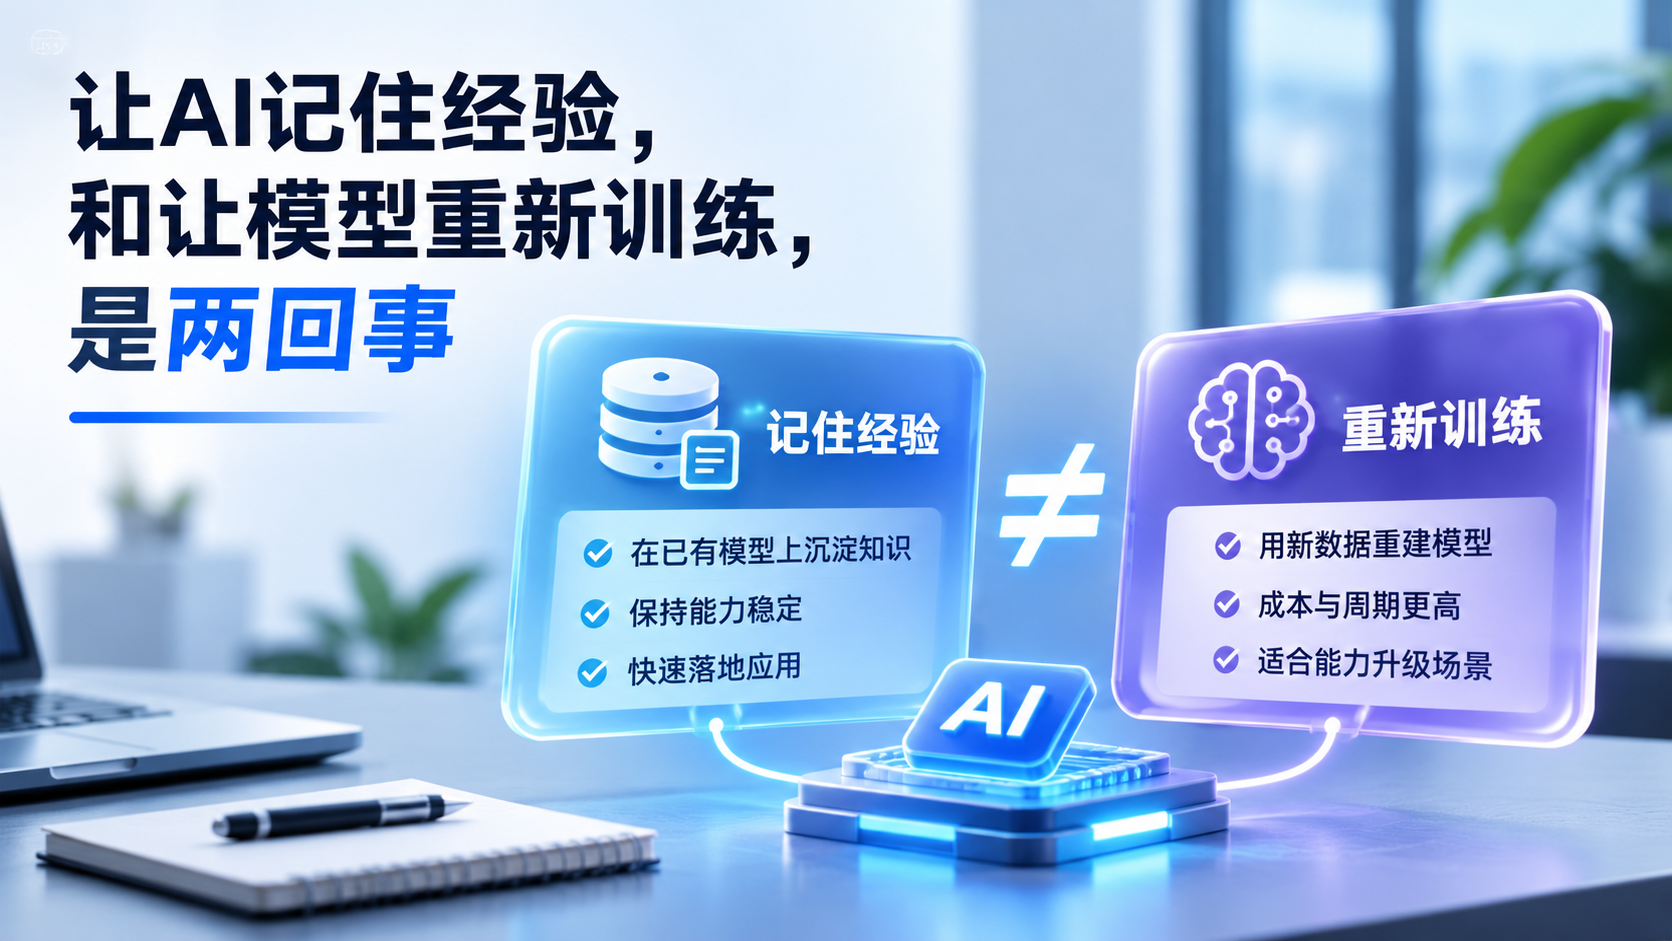
让AI记住经验,和让模型重新训练,是两回事
文/侯彦君
企业上了一套AI系统,用了一段时间,把新案例、员工反馈和处理经验不断往里面加,回答确实比以前更贴业务了。那这能不能算“越用越聪明”?
你要只是说用起来的感觉,那当然可以。但要是进一步说“模型在自动训练”,就得看系统到底干了什么。其实很多时候,模型参数根本没变,变的是它能查到的资料、收到的上下文,还有执行任务时要遵守的规则。
这个区别挺重要的,因为它会影响企业怎么建系统、怎么维护系统。如果你以为只要一直用,AI就会自动把经验吸收进去,错误越来越少,资料也一直最新,那后面很可能要失望。记录怎么存、哪些东西值得留、下次怎么调用,这些都得专门设计。
先说知识更新。假设企业改了一项内部制度,把新文件放进了知识库。员工提问的时候,系统找到相关条款,再把条款和问题一起交给模型,模型根据这些来回答。这就是检索增强生成,也就是大家常说的RAG。
这个过程里,回答用到了新资料,但没必要为了这次更新重新训练模型。对于经常变的产品信息、内部制度和业务要求,这样做更方便保留出处、管理版本和纠正内容。
但文件传上去,不代表更新就生效了。旧版有没有停用,新版有没有正确解析,检索能不能找到相关条款,这些都要检查。就算找到了正确内容,模型也可能漏掉条件或者理解错。所以回答不准的时候,得沿着资料、检索和生成过程一层层查原因,不能一上来就说模型能力不行。
记忆积累又多了点东西:除了查资料,系统还得利用过去发生过的事。
当前对话里的信息,可以直接作为上下文给模型;要是希望换了一轮对话以后还能用,那就保存到外部记录里,后面任务需要的时候再给模型。这种机制可以让系统跨对话用信息,但不等于模型参数已经变了。
不过,把全部聊天记录都存下来,只是完成了“存”这一步。哪些记录跟当前任务有关,哪些已经过时,还得筛。
举个例子,用户一开始说公司准备进一个新市场,后来又明确说计划取消了。如果系统只是一直追加记录,下次还是可能把“准备进入新市场”当成当前事实,继续给市场进入建议。
合理的做法,是记录决定已经变了,让后面调用优先用当前状态;要是需要回顾决策过程,再去查历史记录。不然的话,系统虽然把两次表态都存了,但没处理它们之间的关系。
经验比事实更难整理,因为一件事做成了,不代表当时的做法就能直接当成通用规则。
一个方案能被接受,可能跟当时的预算、客户关系和时间要求都有关系。总结的时候如果只写一句“这种方案有效”,把条件都省了,下次碰到不一样的情况,系统就可能直接照搬。用户没提反对意见,也不能就当答案是没错的。
我做数字专家蒸馏系统的时候,要提取的不光是专家知道什么,还包括他为什么这么判断、什么情况下会改建议,还有哪些问题其实超出了他的能力范围。这里说的“蒸馏”,是指把专家经验提取出来,不代表拿这些材料训练了一个新模型。
比如说,专家处理某类问题,一般是先看哪些条件,再排除掉哪些方案。把这套判断过程整理成案例、检索资料或者任务规则,模型收到这些内容以后就能拿来参考。但如果整理的时候把前提弄丢了,或者执行任务的时候没调到对应规则,输出还是可能跟专家的判断不一样。
这也说明,经验提取完以后,还得验证它有没有被正确使用。资料里写得全不全,跟实际回答能不能照着做,这是两件事,得分开检查。
至于模型训练,一般是通过训练数据和优化过程去更新参数,让模型的输出表现发生变化。这里也不一定非要把“训练”理解成从头训一个大模型:有些微调方法是更新原来的参数,有些则保持基础模型的参数不动,去训练额外的适配器参数。到底算不算发生了训练,不能光看基础模型有没有换,还得看有没有参数更新的过程。
这跟把一份案例存进数据库、检索之后交给模型参考,是有明确区别的。两种办法也可以一起用,不是说只能选一个,更不能觉得只要扯上训练就一定更高级。
企业要解决的问题不一样,选的路子也应该不一样。
如果内部制度经常改,回答又需要给出条款出处,那先把版本和检索做好,日常变化反而更好处理。要是希望模型在一类比较稳定的任务里,能更好地按特定格式或者特定方式来做,那可以再看看微调合不合适,但数据还是得准备,训练完也还要检查有没有达到目标。
训练也没法代替资料更新和权限管理。模型微调过了,不代表它自动就知道刚刚改过的制度,更不代表它就该把同样的信息提供给所有人。
所以,“越用越聪明”这句话背后,得有个能说清楚的变化:是新增了什么知识,修正了哪条记录,积累了哪些检查过的经验,还是做了一次参数训练。
把这些变化说清楚,不光是为了技术上表达准确,也有助于找问题。新制度没用上,就去查版本和检索;已经取消的计划还在影响建议,就去查记忆更新;总结出来的经验被用错了,就检查原来的条件有没有保留。不同原因要不同处理,不能全指望换模型来解决。
验收也可以照着这些变化来。更新一条制度以后,相关问题的回答能不能跟着变;撤销一个决定以后,系统还会不会把旧决定当成事实;纠正一个案例以后,相近任务里是不是还会出现同样的错。拿一组有代表性的任务,对比前后的表现,比单看某一次回答更有说服力。
企业不一定非得先训练自己的模型,才能积累自己的知识和经验。但如果只是存了更多资料、生成了更多总结,却没检查这些东西准不准、过没过期、需要的时候能不能调出来,那就算用得再久,也不能因此就说系统会越来越可靠。
技术参考
[1] Anthropic:Effective context engineering for AI agents。解释上下文管理、压缩及将记录保存在上下文窗口之外、后续再调用的记忆方式。
[2] Hugging Face PEFT文档:LoRA。解释通过训练额外参数实现低秩适配的方法,用于说明基础模型参数保持不变时,仍然可能发生参数训练。